

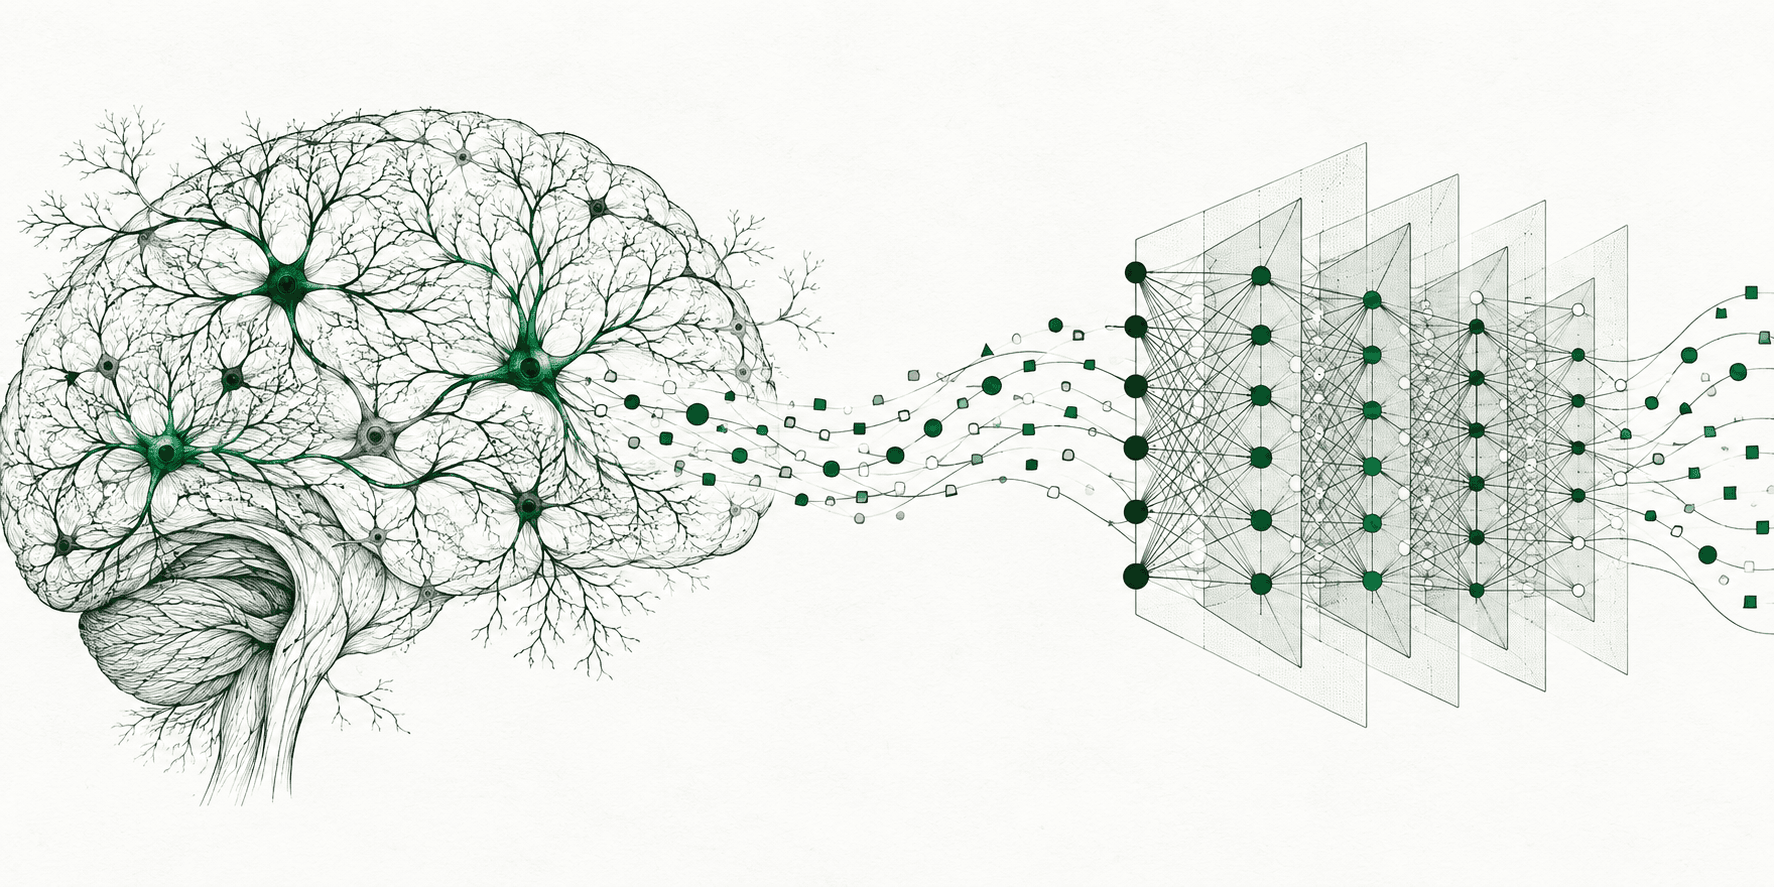
Um pesquisador mostra uma frase a uma pessoa dentro de um aparelho de ressonância magnética. Em outro laboratório, a mesma frase atravessa as camadas de um modelo de linguagem. Os dois experimentos produzem mapas de atividade: de um lado, mudanças no fluxo sanguíneo do córtex; do outro, milhões de números que sobem e descem dentro de um transformer.
Depois, alguém compara os mapas.
Essa cena, que há poucos anos pareceria uma analogia forçada, virou uma linha real de pesquisa. Neurocientistas usam grandes modelos de linguagem para formular hipóteses sobre como o cérebro processa palavras. Pesquisadores de inteligência artificial fazem o movimento inverso: emprestam da neurociência métodos de registro, lesão e estimulação para descobrir o que acontece dentro dos modelos.
Nasceu, na prática, uma neurociência de sistemas que não têm cérebro.
O nome pode enganar. Um LLM não é um cérebro digital, um parâmetro não é uma sinapse e uma unidade artificial não é um neurônio biológico. A comparação útil não está na matéria de que os dois são feitos. Está no problema científico: ambos são redes enormes, distribuídas e difíceis de explicar olhando uma peça de cada vez.
O paradoxo da caixa-preta transparente
O cérebro é opaco por necessidade. Não temos acesso a cada conexão de uma pessoa viva, não podemos interromper qualquer circuito à vontade e quase toda medição é indireta. Em princípio, um modelo de linguagem oferece o oposto: seu código é conhecido, cada peso pode ser lido e cada operação pode ser repetida exatamente.
Mesmo assim, saber tudo o que a máquina calcula não equivale a entender o cálculo.
É possível abrir um arquivo com bilhões de parâmetros sem encontrar ali a regra que faz o modelo traduzir uma frase, completar uma rima ou recuperar o nome de uma capital. O comportamento emerge da interação entre muitos componentes. A transparência física convive com a opacidade funcional.
A neurociência conhece esse problema há muito tempo. Por isso, em vez de perguntar apenas “onde está a linguagem?”, ela combina três operações: observar padrões de atividade, relacioná-los a estímulos e intervir no sistema para testar se uma região é causalmente necessária. A interpretabilidade de LLMs começou a adotar o mesmo roteiro.
Quando a previsão da próxima palavra encontra o cérebro
O primeiro ponto de contato veio da chamada modelagem de codificação. O procedimento é direto: uma pessoa lê ou ouve uma história enquanto pesquisadores registram sua atividade cerebral; em seguida, representações extraídas de um modelo tentam prever os sinais medidos.
Em 2021, um estudo liderado por Martin Schrimpf comparou dezenas de modelos e encontrou uma relação importante: quanto melhor o sistema era em prever palavras, melhor tendia a prever respostas neurais e comportamentais humanas durante o processamento da linguagem. O trabalho não mostrou que cérebro e modelo executam o mesmo algoritmo. Mostrou algo mais restrito e ainda assim relevante: o objetivo de antecipar linguagem captura parte da estrutura que também organiza a resposta humana.
Outro experimento, publicado em 2022, foi além da atividade provocada pela palavra presente. Ao acompanhar pessoas ouvindo uma narrativa, pesquisadores observaram que representações contextuais de um modelo podiam antecipar sinais cerebrais relacionados a palavras que ainda viriam. O cérebro, como o LLM, não recebe cada termo isoladamente. Ele usa o contexto para manter expectativas sobre a continuação.
A direção da comparação também pode ser invertida. Em um estudo publicado na Nature Human Behaviour, Greta Tuckute e colegas deram a um modelo a tarefa de procurar frases que deveriam ativar muito — ou muito pouco — a rede de linguagem do cérebro. Depois colocaram participantes no scanner e testaram as previsões. As frases escolhidas pelo modelo conseguiram elevar e suprimir a resposta da rede em relação a estímulos de controle.
Isso transforma o LLM em mais do que uma metáfora. Ele passa a funcionar como um gerador de hipóteses experimentais: vasculha um espaço de frases grande demais para um laboratório explorar manualmente e aponta estímulos capazes de separar explicações concorrentes.
Há um limite decisivo, porém. Prever um sinal de ressonância não prova identidade de mecanismo. Dois sistemas podem produzir padrões semelhantes por caminhos diferentes, e a própria ressonância reúne a atividade de populações enormes de células numa medida lenta e indireta. A correlação é uma pista, não uma certidão de parentesco.
Lesionar uma ideia, estimular uma ponte
Dentro dos modelos, a inspiração neurocientífica é ainda mais literal.
Pesquisadores registram ativações como quem registra disparos neurais. Desligam componentes e observam a perda de desempenho, num equivalente computacional dos estudos de lesão. Aumentam uma ativação e medem a mudança de comportamento, como numa estimulação. Seguem conexões entre camadas para reconstruir circuitos que levam uma informação da entrada até a resposta.
O primeiro obstáculo é que conceitos raramente moram em unidades individuais. Uma mesma unidade pode participar de assuntos sem relação aparente, enquanto um único conceito se distribui por muitas unidades. Esse fenômeno é chamado de superposição: o modelo reutiliza as mesmas dimensões para representar mais coisas do que caberiam numa correspondência simples entre um neurônio e uma ideia.
Uma das tentativas de separar essa mistura usa sparse autoencoders, ou autoencoders esparsos. Eles aprendem um dicionário de padrões recorrentes de ativação. Em vez de procurar o “neurônio de São Francisco”, procuram uma combinação distribuída que se acende diante da Golden Gate Bridge, de referências à cidade ou de descrições semanticamente próximas.
Em 2024, pesquisadores da Anthropic aplicaram o método a um modelo de produção e extraíram milhões desses padrões, chamados de features. O resultado mais conhecido foi justamente a feature da Golden Gate. Quando ela foi artificialmente intensificada, o modelo passou a mencionar a ponte em contextos nos quais ela não cabia e chegou a descrevê-la como parte da própria identidade.
O experimento importa menos pela excentricidade da resposta do que pelo verbo: intervir. Se a manipulação de um padrão altera o comportamento previsto, o pesquisador tem evidência causal, não apenas uma visualização bonita.
Há outras formas de cirurgia. O método ROME, apresentado em 2022, localizou componentes envolvidos na recuperação de associações factuais e conseguiu editar fatos específicos em modelos — trocar, por exemplo, a cidade associada a uma entidade — com efeitos relativamente localizados. Trabalhos mais recentes tentam reconstruir circuitos completos: quais representações detectam a pergunta, quais recuperam informação e quais empurram a próxima palavra na direção da resposta.
É a diferença entre saber que uma região se ilumina e entender a cadeia de eventos que faz a luz acender.
O que aparece quando abrimos o modelo
Os mapas produzidos até agora sugerem que LLMs não operam apenas por associação superficial entre palavras vizinhas. Eles formam representações abstratas que atravessam contextos e, em alguns casos, idiomas.
Em experimentos divulgados em 2025, pesquisadores rastrearam circuitos internos de Claude durante tarefas de tradução, aritmética e composição de versos. Encontraram sinais compatíveis com conceitos compartilhados entre línguas e com planejamento antecipado: ao escrever poesia, o modelo selecionava possibilidades de rima antes de completar o verso. Também observaram casos em que a explicação verbal dada pelo sistema não correspondia bem ao caminho registrado dentro dele.
Esses resultados ajudam a desfazer duas caricaturas opostas. O LLM não é um banco de frases que apenas recorta trechos memorizados. Mas também não é uma pessoa minúscula raciocinando dentro do servidor. Há computação estruturada, representações e planejamento; isso não transforma o mecanismo em experiência humana.
As reconstruções continuam parciais. No estudo de circuitos, os próprios autores conseguiram explicar apenas uma fração da computação total usada em cada resposta. Métodos diferentes podem destacar features diferentes, e uma descrição legível para humanos não é necessariamente a decomposição “verdadeira” do modelo. O microscópio também molda o que aparece na lâmina.
A fronteira onde a analogia quebra
As palavras usadas nos dois campos — neurônio, atenção, memória, representação — dão uma impressão de continuidade maior do que a evidência permite.
Neurônios biológicos são células vivas, eletroquímicas, conectadas a um corpo que regula fome, dor, movimento, sono e sobrevivência. Aprendem continuamente, em várias escalas de tempo, enquanto recebem informação de muitos sentidos e agem sobre o mundo. As unidades de um transformer são operações matemáticas organizadas em camadas. Durante uma resposta comum, seus pesos ficam parados; o que muda é o estado produzido pelos tokens no contexto.
O cérebro humano também não foi treinado para minimizar apenas o erro de previsão da próxima palavra. Linguagem é uma parte de um organismo moldado por percepção, ação, vínculo social e desenvolvimento. O LLM recebe uma fatia extraordinariamente rica da cultura humana, mas recebe essa fatia como dados.
Por isso, três saltos devem ser evitados:
Semelhança de representação não é identidade de processo. Dois sistemas podem organizar significados de modo parecido porque enfrentam a mesma tarefa, sem executar os mesmos passos.
Informação decodificável não é informação usada. Uma sonda pode encontrar um padrão dentro do modelo mesmo que esse padrão não cause a decisão final; a intervenção é o teste mais forte.
Complexidade interna não é evidência de consciência. Circuitos, planejamento e autorrelatos não demonstram experiência subjetiva. Os experimentos atuais não resolvem essa questão.
Chamar esse campo de neurociência de LLMs é produtivo se a expressão descreve um conjunto de métodos. Torna-se enganoso quando vira uma afirmação sobre a natureza da máquina.
Por que abrir essa caixa importa
Interpretabilidade não é apenas curiosidade acadêmica. Um modelo pode dar a resposta certa pelo motivo errado, esconder um viés que não aparece nos testes comuns ou aprender uma regra frágil que falha fora da distribuição de treinamento. Avaliar somente entradas e saídas é como certificar um medicamento observando que o paciente melhorou uma vez, sem estudar dose, mecanismo ou efeitos colaterais.
Mapas internos podem ajudar a identificar quando uma resposta vem de conhecimento recuperado, de um palpite estatístico ou de uma tentativa de seguir a expectativa do usuário. Intervenções podem testar se um mecanismo de segurança é robusto ou se apenas encobre uma capacidade que continua disponível. E circuitos bem compreendidos podem permitir correções menores do que treinar novamente um modelo inteiro.
Para a neurociência humana, a troca também é valiosa. LLMs são organismos-modelo peculiares: podem ser copiados, dissecados e submetidos ao mesmo experimento milhares de vezes. Eles não substituem o cérebro, mas permitem testar ferramentas de análise em um sistema no qual o pesquisador conhece toda a conectividade e controla toda a história de treinamento.
O paradoxo permanece. Construímos essas máquinas linha por linha e, depois de treinadas, precisamos estudá-las como se fossem um fenômeno encontrado na natureza. Isso não significa que tenham virado cérebros. Significa que conhecer as peças deixou de ser suficiente para explicar o todo.
A melhor neurociência dos LLMs começa justamente aí: menos interessada em declarar que a máquina pensa como nós e mais disposta a medir, intervir e descobrir onde a comparação funciona — e onde termina.
Fontes primárias: Schrimpf et al., PNAS (2021); Goldstein et al., Nature Neuroscience (2022); Tuckute et al., Nature Human Behaviour (2024); Bricken et al., Towards Monosemanticity (2023); Templeton et al., Scaling Monosemanticity (2024); Meng et al., Locating and Editing Factual Associations in GPT (2022); Lindsey et al., On the Biology of a Large Language Model (2025).